Depuis quelque temps, j’ai deux Lenovo ThinkStation PGX au bureau. Deux boîtiers, chacun avec une GB10, reliés à 200 Gb/s. C’est en fait des Nvidia DGX Spark, mais chez Lenovo.
La question n’était pas “qu’est-ce que je peux faire tourner dessus” ça, je le savais déjà, tout le monde sait lancer un ollama run et regarder les tokens défiler. La vraie question, celle qui alimente la série que je prépare sur l’IA locale et souveraine (deux mots très à la mode), c’était :
Est-ce que ce matériel peut réellement remplacer un abonnement cloud ?
Pour y répondre, dans cette nouvelle série de blog posts, on va faire beaucoup de tests et on va extraire tout le jus que ces machines peuvent nous apporter.
Pour commencer, j’ai choisi de tester le nouveau DeepSeek-V4-Flash-0731.
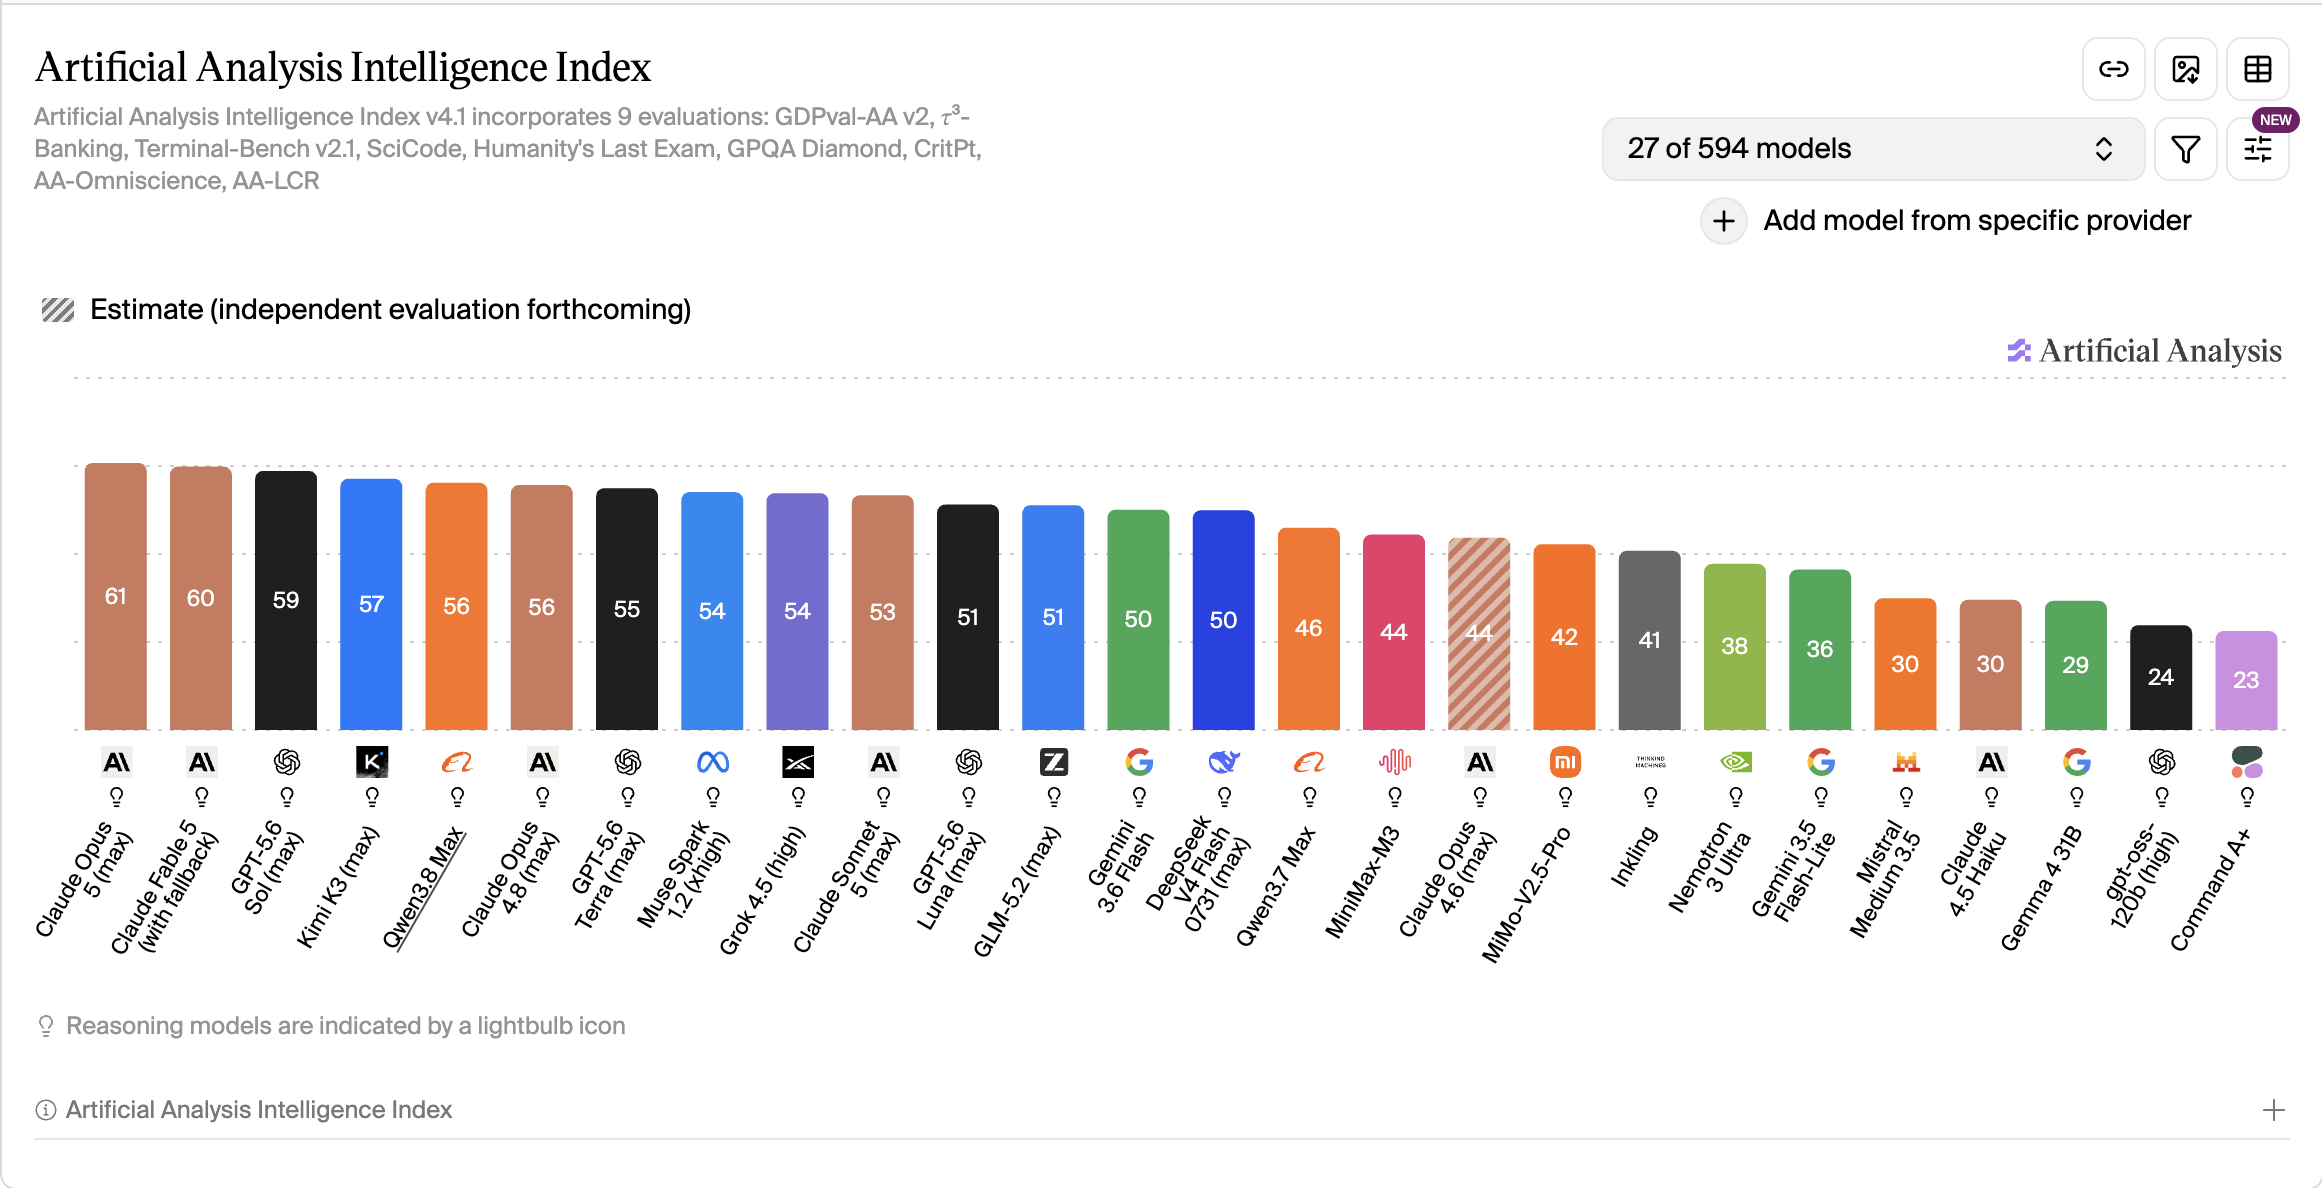
Le modèle venait de sortir : 284 milliards de paramètres, mais une architecture MoE qui n’en active qu’environ 13 milliards par token, un contexte pouvant grimper jusqu’à 1M de tokens, et une version NVFP4 pensée pour le matériel que j’avais sous la main. Sur le papier, exactement ce qu’il fallait pour un cluster de deux GB10.
Juste pour vous donner un ordre de grandeur, le modèle est plus puissant que le fameux Claude Opus 4.6, qui il y a quelques mois m’impressionnait. Donc en fait, on a une super intelligence, totalement locale !
La méthodologie
Ce qu’on va faire dans cet article pour voir si ça vaut vraiment le coup de dépenser autant d’argent sur du hardware. On va :
- Déployer le modèle sur les deux PGX
- Faire des benchmarks pour voir ce que ça donne en vrai
La liste n’est pas très longue, mais déjà l’étape 1, l’installation, a été un vrai parcours du combattant. Surtout moi à l’université, et le proxy qui fait des siennes.
Et la partie la plus amusante, les benchmarks, est vraiment intéressante, genre vraiment je ne m’attendais pas à d’aussi bonnes performances, à une telle vitesse, et surtout une telle stabilité. Je vous laisse découvrir les résultats dans la suite.
Mais d’abord, l’installation.
Déploiement du modèle sur deux PGX
D’abord il faut bien entendu que les deux boîtiers puissent communiquer entre eux avec ssh sans mot de passe, donc avec une simple clef ssh. Je suis sûr que vous pouvez le faire.
Aussi il faut que les deux boîtiers aient docker, et que le user avec lequel vous vous connectez par ssh puisse lancer des containers.
Une fois que c’est fait, sur le nœud que vous préférez (oui j’ai un PGX que je préfère), vous clonez le repo :
git clone https://github.com/tonyd2wild/DeepSeek-v4-Flash-0731-DSpark-1M-NVFP4-KV-2x-DGX-Spark.git

cd ./DeepSeek-v4-Flash-0731-DSpark-1M-NVFP4-KV-2x-DGX-Spark
Une fois que c’est bon, et pour qu’il n’y ait pas d’erreurs de version, et faire que le blog post soit le plus pérenne possible, faites un checkout sur le commit que j’ai utilisé pour mes tests :
git checkout d728faee9f5a8d5ebafe7bc44bca6c5d8d0d192f
Une fois que c’est bon, on va quand même tester le boîtier distant avec :
ssh -o BatchMode=yes adtmin@pgx2 \
  'hostname; docker version --format "{{.Server.Version}}"'
Maintenant, on doit identifier c’est quoi le GID RoCE, c’est celui de l’interface où votre câble 200Gb/s est connecté, donc :
show_gids
ssh adtmin@pgx2 show_gids
Vous aurez un tableau comme suit :
DEV     PORT    INDEX   GID                                     IPv4            VER     DEV
---     ----    -----   ---                                     ------------    ---     ---
rocep1s0f0      1       0       fe80:0000:0000:0000:3aa7:xxxx:xxxx:xxxx                 v1      enp1s0f0np0
rocep1s0f0      1       1       fe80:0000:0000:0000:3aa7:xxxx:xxxx:xxxx                 v2      enp1s0f0np0
rocep1s0f0      1       2       0000:0000:0000:0000:0000:xxxx:xxxx:xxxx 192.168.xxx.10          v1      enp1s0f0np0
rocep1s0f0      1       3       0000:0000:0000:0000:0000:xxxx:xxxx:xxxx 192.168.xxx.10          v2      enp1s0f0np0
rocep1s0f1      1       0       fe80:0000:0000:0000:3aa7:xxxx:xxxx:xxxx                 v1      enp1s0f1np1
rocep1s0f1      1       1       fe80:0000:0000:0000:3aa7:xxxx:xxxx:xxxx                 v2      enp1s0f1np1
rocep1s0f1      1       2       0000:0000:0000:0000:0000:xxxx:xxxx:xxxx 192.168.xxx.12          v1      enp1s0f1np1
Vous devez repérer le GID de l’interface sur laquelle votre câble 200Gb/s est branché, et le noter. Dans mon cas, c’est le GID de l’interface rocep1s0f1, donc 0.
Si vous ne le connaissez pas, vous avez du mal à comprendre, normalement le 0 suffit.
Une fois que c’est fait, il faut modifier le .env.dspark pour le configurer sur nos infos :
cp .env.dspark.example .env.dspark
nano .env.dspark
Vous pouvez tout laisser par défaut, mais les variables à modifier sont :
pgx1 & pgx2 c’est les adresses du câble 200Gb/s !
WORKER_HOST=pgx2
WORKER_SCRIPT_DIR=/chemin/vers/le/repo/DeepSeek-v4-Flash-0731-DSpark-1M-NVFP4-KV-2x-DGX-Spark
MASTER_ADDR=pgx1


VLLM_HOST_IP=pgx1
WORKER_VLLM_HOST_IP=pgx2
VLLM_HOST=0.0.0.0
VLLM_PORT=8888

NCCL_IB_HCA=rocep1s0f0
NCCL_SOCKET_IFNAME=enp1s0f0np0
NCCL_IB_GID_INDEX=gid_index_de_votre_interface_200Gb/s
NCCL_CROSS_NIC=1
NCCL_DEBUG=INFO

HF_CACHE=/home/xxxx/.cache/huggingface
WORKER_HF_CACHE=/home/xxxx/.cache/huggingface
HF_HUB_DISABLE_XET=1

DSPARK_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
SERVED_MODEL_NAME=deepseek-v4-flash-dspark
DSPARK_VLLM_IMAGE=vllm-dspark-runtime:dspark-nvfp4-stage-c

MAX_MODEL_LEN=1048576
MAX_NUM_SEQS=6
MAX_NUM_BATCHED_TOKENS=8192
GPU_MEMORY_UTILIZATION=0.78
MTP_NUM_TOKENS=5

PYTORCH_CUDA_ALLOC_CONF=expandable_segments:False
VLLM_SKIP_INIT_MEMORY_CHECK=0

HF_HUB_OFFLINE=0
TRANSFORMERS_OFFLINE=0
Et maintenant si tout a été bien configuré, il suffit de lancer ce script :
cd ~/DeepSeek-v4-Flash-0731-DSpark-1M-NVFP4-KV-2x-DGX-Spark

./build-dspark-vllm-runtime.sh
Ce script va construire l’image docker sur le nœud principal, puis la transférer sur le worker.
Pour moi cette étape n’a pas marché, sur le nœud principal la construction de l’image a réussi du premier coup. Sur le worker, en revanche, échec systématique, toujours au même endroit, impossible de joindre le serveur d’authentification de GHCR.
Le réflexe, c’est de vérifier le proxy. Je suis à l’université et je n’ai pas encore accès au réseau recherche, donc je passe comme tout le monde derrière un réseau étudiant avec proxy. J’ai lancé docker run --rm ubuntu:24.04 env | grep -i proxy sur les deux machines : les variables étaient bien là, dans le conteneur. Le proxy fonctionnait. Et pourtant, le build échouait toujours au même endroit.
Le problème venait d’une confusion simple, la variable d’environnement que voit un conteneur lancé avec docker run n’a rien à voir avec celle que voit le daemon BuildKit qui orchestre la construction de l’image. Le premier tourne dans le conteneur applicatif, le second comme service systemd, avec son propre environnement, invisible depuis un simple docker run. J’avais vérifié le mauvais proxy pendant tout ce temps.
À ce stade, deux options : reconfigurer le proxy du daemon Docker au niveau systemd sur le worker, ou arrêter de me battre contre GHCR sur cette machine. J’ai choisi la seconde. L’image finale existait déjà, validée, sur le head. Il suffisait de la transférer telle quelle :
docker save vllm-dspark-runtime:dspark-nvfp4-stage-c \
  | pv \
  | ssh -o Compression=no [email protected] 'docker load'
Une commande, aucune dépendance à GHCR côté worker, et un bonus auquel je ne m’attendais pas : les deux nœuds tournent désormais avec une image strictement identique docker image inspect renvoie le même hash des deux côtés. Plus de dérive possible entre les deux rangs du cluster.
Une fois que le build est terminé, il faut maintenant télécharger le modèle :
./prepare-dspark-model-cache.sh
Et lorsque c’est bon, on commence une nouvelle session tmux sur le nœud principal, et on lance le script qui démarre le worker puis le head :
tmux new -s deepseek
cd ~/DeepSeek-v4-Flash-0731-DSpark-1M-NVFP4-KV-2x-DGX-Spark

./start-deepseek-v4-flash-dspark.sh
ça va prendre à peu près 15/20 minutes, le temps que le modèle se charge, que les graphes CUDA soient capturés, et que le worker et le head soient prêts à recevoir des requêtes.
Pour info moi le script de lancement il a marché parfaitement, mais malgré que le modèle soit prêt à recevoir des requêtes, sur mon tmux je voyais toujours des erreurs 503, donc n’hésitez pas à lancer un nvtop sur un terminal à côté, et dès que vous voyez la GPU ne plus travailler après un certain moment lancez le curl de test, sinon vous allez vous arracher les cheveux à chercher pourquoi ça ne marche pas. Alors que ça marche :)
Et une fois que c’est bon, on peut lancer notre premier curl :
curl -fsS http://127.0.0.1:8888/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "deepseek-v4-flash-dspark",
    "messages": [
      {
        "role": "user",
        "content": "Réponds exactement : DSPARK OK"
      }
    ],
    "max_tokens": 16,
    "temperature": 0
  }' | python3 -m json.tool
Et ça marche !
Ce que ça donne en vrai
Je vous laisse d’abord les résultats bruts. J’ai relancé le benchmark cinq fois, pour vérifier que les chiffres ne tombaient pas du ciel.
=== pgx-2x-0731 @ http://127.0.0.1:8888/v1 ===

--- DECODE by content (temp 0, warm), 5 runs ---
             R1      R2      R3      R4      R5   mean
count300   86.0    85.3    84.3    85.2    85.3    85.2
mult12     80.3    80.4    80.0    80.1    79.9    80.1
json60     80.2      —      80.1    80.1    80.0    80.1
bst        66.8    66.8    66.4    66.2    66.3    66.5
story      34.8    32.8    32.4    31.3    31.5    32.6
  PEAK 86.0 (count300)   MEAN 68.6

--- CONCURRENCY (same prompt, 400 tok each) — agg tok/s ---
             R1      R2      R3      R4      R5   mean
 c1        70.5    70.8    70.9    72.9    71.8    71.4
 c2       127.2   111.1   129.8   119.7   119.5   121.5
 c4       180.7   183.2   149.9   194.2   174.2   176.4
 c6       224.6   196.0   191.5   208.1   210.5   206.1

--- PREFILL (TTFT method, 1 output token) ---
             R1      R2      R3      R4      R5   mean
 8k       1869    1876    1883    1352    1876    1876
32k       2572    2577    2466    2564    2578    2571
100k      2593    2600    2668    2590    2593    2609

===== SUMMARY [pgx-2x-0731] =====
decode peak 86.0 | mean 68.6
concurrency agg: c1=71  c2=121  c4=176  c6=206
prefill: 8K=1876t/s  32K=2571t/s  100K=2609t/s
J’ai retiré du tableau deux runs aberrants : un json60 à 11,6 tok/s (la génération s’est arrêtée à 5 tokens, pas un vrai run) et un prefill 8k à 1352 tok/s. Le reste est stable, à quelques dixièmes près, ce qui me laisse dire les choses suivantes avec une certaine confiance.
68,6 tok/s de moyenne, mais pas dans toutes les situations. Le pic à 86 tok/s est le chiffre qui saute aux yeux, mais il masque une vraie variance selon le type de génération : sur du comptage ou du JSON, contraint, je dépasse facilement les 80 tok/s ; sur la génération d’une histoire, plus libre, je tombe à 32,6 tok/s. Ce n’est pas un détail : ça veut dire que ta vitesse dépend beaucoup de ce que tu demandes au modèle.
La raison, c’est le MTP. Par défaut, le dépôt lance le modèle avec cette configuration : un tout petit modèle prédit des tokens en parallèle, et le gros les valide en bloc. Quand ce qui vient est prévisible, comme du code ou du JSON, le gros modèle valide plusieurs tokens d’un coup, donc moins de passages par token généré. Quand c’est moins prévisible, comme une histoire libre, il n’est pas d’accord avec les propositions et on retombe sur un seul passage par token. D’où l’écart entre 80 et 32 tok/s.
Le batching suit un scaling quasi-linéaire jusqu’à 6 requêtes. L’agrégat grimpe régulièrement de 71 à 206 tok/s entre une et six requêtes simultanées, soit ~3× plus de débit. Autrement dit, sur la plage testée, ajouter des requêtes ne fait pas chuter le débit global : ça le remplit. Jusqu’où ça tient, c’est une autre question, et je n’ai pas mesuré au-delà de six.
Le préfill ne s’effondre pas avec les longs prompts. Je passe d’environ 1870 tok/s sur un prompt de 6 234 tokens à plus de 2600 tok/s sur près de 78 000 tokens, le débit augmente puis se stabilise plutôt que de chuter. Ça peut s’expliquer par une meilleure saturation du matériel et l’amortissement des coûts fixes sur les prompts longs. Ça ne prouve pas que le lien RDMA à 200 Gb/s ne sera jamais le facteur limitant, mais jusqu’à 100 000 tokens de contexte, je n’observe aucun effondrement brutal — plutôt rassurant pour une machine pensée pour les gros contextes.
Pour ce que j’en fais au quotidien ? Depuis que j’ai installé ce modèle, je l’utilise avec Opencode, et il marche vraiment très bien : aucun problème de stabilité, aucune erreur bête. C’est la première fois depuis un moment que j’arrive à travailler pendant des heures sans surveiller un quota ou attendre la réinitialisation d’une limite de 5 heures — et je peux vous dire que ça fait vraiment du bien.
Le vrai problème : plus de 15 minutes de cold start
Le premier démarrage est long. Chargement des poids, initialisation des processus distribués, compilation, autotuning, capture des graphes CUDA, et tout le tralala : plus de 15 minutes avant le premier token. Pour une machine qui reste allumée et sert des requêtes toute la journée, ce n’est pas dramatique. Pour un usage occasionnel, ou une infra qui doit démarrer à la demande, c’est nettement plus embêtant.
C’est exactement le sujet sur lequel je travaille maintenant, le GPU checkpointing sur GB10. Un sujet qui m’intéresse depuis un moment, mais qui devient beaucoup plus concret avec 15 minutes de cold start devant moi. L’idée : capturer l’état d’un processus CUDA déjà chaud poids en VRAM, graphes capturés, KV cache prêt et le restaurer en quelques secondes via une version adaptée de CRIU à la mémoire unifiée du GB10, plutôt que de tout recharger à froid à chaque fois. Si ça aboutit, la ligne “cold start” de cet article devient obsolète. Je vous en reparle bientôt.
Et maintenant ?
Cet article de blog pose le premier chiffre de la série que je prépare sur l’IA locale et souveraine. La suite : consommation électrique réelle, coût par million de tokens, performances à plusieurs utilisateurs, intérêt des très longs contextes, stabilité sur plusieurs jours et la question qui fâche, rentabilité face au cloud ou FOMO matériel.
Le dépôt complet que j’ai utilisé, patches inclus, est ici : tonyd2wild/DeepSeek-v4-Flash-0731-DSpark-1M-NVFP4-KV-2x-DGX-Spark.
Vous avez tenté quelque chose de similaire sur du GB10 ou équivalent ? 68,6 tok/s en moyenne sur deux boîtiers de bureau, c’est un chiffre à saluer ou à relativiser ?